
Les données sont la matière première de toute activité numérique. Pour qu'on puisse les exploiter, il faut les structurer. Dans cette séance, on définit ce qu'est une donnée et une donnée personnelle, on ouvre un fichier CSV qui décrit votre classe, on apprend à le trier et à le filtrer avec un tableur — des gestes dont vous aurez besoin pour dépouiller l'enquête du lycée — et on découvre ce que ces deux opérations, si banales, permettent de faire sur un fichier parfaitement anonyme.
- Donnée
- Une valeur ou une information décrivant un objet, une personne, un événement, etc.
- Donnée personnelle
- Toute information se rapportant à une personne physique identifiée ou identifiable.
Une personne physique peut être identifiée :
✍️ Question 1 : Donnez deux autres exemples de données qui permettent d'identifier indirectement une personne.
L'identification peut se faire à partir d'une seule donnée, ou à partir du croisement d'un ensemble de données — par exemple : une femme habitant à telle adresse et membre de telle association.
Retenez ce mot : croisement. Nous allons y revenir à la fin de la séance.
Votre enseignant vous transmet le fichier de votre classe, nommé classe_SNT_ suivi du nom de
la classe (par exemple classe_SNT_2B.csv). Il décrit votre classe : une ligne par élève.
Il ne contient aucun nom, aucun prénom, aucune date de naissance complète, et le numéro
id de chaque ligne a été tiré au hasard : il ne suit pas l'ordre alphabétique de la liste de
classe. Il est parfaitement anonyme.
Attention : pour la réussite de la séance, on ne dit jamais à qui correspond une ligne — ni à voix haute, ni par écrit. Pas même la sienne.
Pas de LibreOffice Calc sur votre ordinateur personnel ? Ouvrez le tableur en ligne Capytableur par le lien donné sur l'ENT : le fichier y est déjà chargé. Dans l'aide-mémoire de la partie 3, choisissez alors l'onglet « Capytableur ».
Voici à quoi ressemble le début du fichier dans l'éditeur de texte (les valeurs ci-dessous sont inventées) :
id;sexe;mois_naissance;commune;college_origine;regime;lv2;option1;option2
1;F;3;ANGERS;Jean Vilar;demi-pensionnaire;espagnol;aucune;aucune
2;M;11;AVRILLE;;externe;espagnol;euro;aucune
3;F;7;ANGERS;Montaigne;demi-pensionnaire;espagnol;eps;aucune
Ce fichier est au format CSV (Comma-Separated Values, « valeurs séparées par des virgules »).
- Fichier CSV
- Un simple fichier texte qui représente un tableau : chaque ligne du texte correspond à une ligne du tableau.
- Descripteurs
- Les noms des colonnes, donnés par la première ligne :
id,sexe,commune…- Objet
- Ce que décrit chacune des lignes suivantes — ici, un élève.
- Valeur
- Le contenu d'une case.
- Séparateur
- Le caractère placé entre deux valeurs : la virgule en anglais, souvent le point-virgule en français, parce que la virgule y sert déjà à écrire les nombres décimaux.
- Valeur manquante
- Une case restée vide (deux séparateurs qui se suivent,
;;). Presque tous les jeux de données réels en contiennent.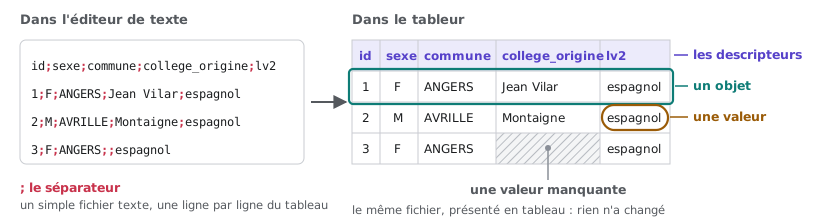
✍️ Question 2 : Combien d'objets et combien de descripteurs contient ce fichier ? Quel est le séparateur utilisé ?
✍️ Question 3 : Décrivez en une phrase ce que fait le tableur par rapport à l'éditeur de texte. Le fichier a-t-il changé entre les deux ouvertures ?
Quand on dispose de données structurées, deux opérations reviennent sans cesse. Vous les pratiquez déjà sans y penser sur un site de vente en ligne : on trie les articles par prix, on filtre pour n'afficher qu'une marque.
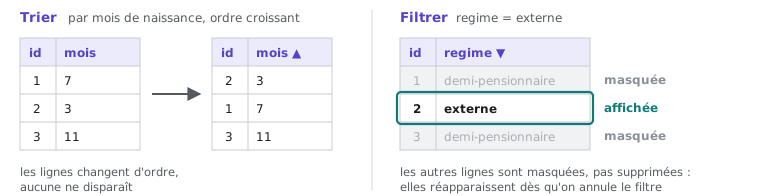
Ni le tri ni le filtre ne suppriment de données : les lignes masquées par un filtre réapparaissent dès qu'on l'annule.
🧰 Aide-mémoire — choisissez votre logiciel :
Dans LibreOffice Calc, cliquez d'abord dans une case du tableau, puis :
Pour… Menu trier Données > Trier… : choisir la colonne (« clé de tri ») et l'ordre filtrer sur une ou plusieurs colonnes Données > AutoFiltre : une flèche apparaît dans chaque en-tête ; on coche les valeurs à garder.
Si AutoFiltre ne peut pas être sélectionné correctement, pensez à sélectionner au préalable une cellule de la première ligne (un descripteur).filtrer avec une condition (supérieur à, contient…), ou plusieurs conditions à la fois Données > Plus de filtres > Filtre standard… : une ligne par condition ; à partir de la deuxième ligne, la colonne Opérateur relie la condition à la précédente par ET ou par OU compter les lignes affichées cliquer dans une seule case du tableau, puis lire la barre d'état, en bas à gauche : « 12 sur 30 enregistrements trouvés ».
Ce comptage n'apparaît que si l'AutoFiltre est activé (flèches dans les en-têtes).tout réafficher Données > Plus de filtres > Réinitialiser le filtre Dans Capytableur, le fichier de votre classe est déjà chargé dans l'activité Capytale. Puis :
Pour… Dans Capytableur trier LIGNES/COLONNES > Options de lignes > Trier les lignes : laisser coché « la ligne 1 est un en-tête » puis choisir la colonne et l'ordre. filtrer sur une ou plusieurs colonnes Se positionner sur une colonne (A, B, C, etc.) > cliquer sur l'icône Entonnoir > onglet Valeurs : on coche les valeurs à garder. filtrer avec une condition (supérieur à, contient…), ou plusieurs conditions à la fois Se positionner sur une colonne (A, B, C, etc.) > cliquer sur l'icône Entonnoir > onglet Conditions : on choisit la condition (Numérique ou textuelle) et on saisit la valeur de la condition souhaitée (on peut ajouter d'autres conditions grâce au bouton « + Ajouter une condition ») et on clique sur Valider. Pour filtrer avec des conditions sur plusieurs colonnes à la fois, il faut répéter cela pour chaque colonne. compter les lignes affichées Après un filtre, on peut lire en bas à droite de l'écran le nombre de lignes filtrées : « 12 sur 30 lignes affichées » tout réafficher Il faut annuler tous les filtres en cours : cliquer sur l'icône Entonnoir sur toutes les colonnes qui ont un filtre actif (l'icône est alors visible en bleu) puis cliquer sur Retirer.
Attention : annulez tous les filtres avant de commencer chaque question.
Répondez aux questions en utilisant uniquement le tri et le filtre, sans compter à la main.
Dans Capytableur, qui n'affiche pas le nombre de lignes : comptez les lignes affichées.
💻✍️ Question 4 : Triez le fichier par mois_naissance, dans l'ordre croissant. Quel est
le mois de naissance le plus fréquent dans la classe ? Pourquoi le tri le fait-il apparaître
immédiatement ?
💻✍️ Question 5 : Avec l'AutoFiltre, n'affichez que les élèves demi-pensionnaires. Combien sont-ils ?
💻✍️ Question 6 : Sans annuler le filtre précédent, ajoutez une deuxième condition sur la
colonne sexe : n'affichez que les filles (F). Combien de lignes reste-t-il ?
💻✍️ Question 7 : Avec le filtre standard, n'affichez que les élèves nés au second semestre
(mois_naissance supérieur ou égal à 7), puis triez le résultat par commune. Combien de
communes différentes apparaissent ?
💻✍️ Question 8 : Avec le filtre standard, n'affichez que les élèves nés en été, de juin
à août. Il faut deux conditions sur la colonne mois_naissance, reliées par l'opérateur
ET : mois_naissance ≥ 6 ET mois_naissance ≤ 8. Combien sont-ils ? Que se
passerait-il si l'on reliait ces deux conditions par OU ? Avec Capytableur, cette question n'est pas réalisable pour l'instant : le logiciel ne permet pas encore deux conditions sur une même colonne.
Regardez ce qui s'est passé entre les questions 5 et 6 : chaque condition ajoutée fait baisser le nombre de lignes affichées. Jusqu'où peut-on descendre ?
💻✍️ Question 9 : Ouvrez la flèche de l'AutoFiltre de la colonne college_origine. Quelle
valeur particulière apparaît dans la liste ? Combien d'élèves sont concernés ? Peut-on en
conclure que ces élèves ne viennent d'aucun collège ?
💻✍️ Question 10 : Quelle(s) colonne(s) ne prennent qu'une seule valeur dans votre classe ? Une telle colonne permet-elle de distinguer deux élèves ? Valait-il la peine de la collecter ?
Vous êtes le seul à connaître à coup sûr vos propres valeurs. Avec l'AutoFiltre, cherchez votre ligne :
sexe ;mois_naissance, puis commune, puis les colonnes de
votre choix — et notez (dans le tableau ci-dessous) après chacune le nombre de lignes encore affichées ;⚠️ La règle de départ s'applique : vous ne dites à personne quelle ligne est la vôtre.
| Condition ajoutée | Lignes encore affichées |
|---|---|
sexe = … |
|
+ mois_naissance = … |
|
+ commune = … |
|
| + … |
💻✍️ Question 11 : Combien de conditions a-t-il fallu pour qu'il ne reste que vous ? Si vous n'avez jamais été seul, combien de lignes ont gardé exactement les mêmes valeurs que vous ? D'après votre tableau, que se passe-t-il chaque fois qu'on ajoute une colonne ? Qu'en concluez-vous sur les données qu'il est raisonnable de collecter ?
✍️ Question 12 : Le fichier ne contient aucun nom. Un camarade qui l'aurait sous les yeux pourrait-il retrouver votre ligne ? De quoi aurait-il besoin, en plus du fichier ? Et une personne qui ne sait rien de votre classe — ou une IA à qui l'on montrerait le fichier ?
Ce que vous venez de faire, c'est une ré-identification. Une valeur rare suffit parfois, à elle seule, à désigner quelqu'un — une commune ou un collège que personne d'autre n'a dans la classe. Le plus souvent, c'est le croisement de quelques colonnes banales qui le fait : chacune laisse beaucoup de monde, toutes ensemble ne laissent plus qu'une personne. Un fichier n'est donc pas anonyme en soi : il est anonyme pour quelqu'un qui ne sait rien d'autre.
Ce n'est pas anodin, loin de là ! En 1997, Latanya Sweeney, alors doctorante au MIT, a
ré-identifié le dossier médical du gouverneur du Massachusetts, William Weld. L'État venait
de publier les dossiers hospitaliers de ses fonctionnaires, « anonymisés » : les noms et les
adresses avaient été retirés, mais pas le code postal, la date de naissance et le sexe des
patients. Pour 20 dollars, elle a acheté la liste électorale de la ville de Cambridge, où vivait
le gouverneur : elle contient ces trois informations, avec les noms. Le croisement des deux
fichiers lui a permis de retrouver le dossier du gouverneur, qu'elle lui a fait parvenir.
Par la
suite, elle a montré que 87 % des habitants des États-Unis pouvaient être identifiés à partir
de ces trois seules informations. Vous venez de faire presque la même chose avec le sexe, le
mois de naissance et la commune.
La leçon à en tirer est simple : retirer les noms ne suffit pas, parce que les autres colonnes, ensemble, forment une empreinte.
Plus on ajoute de colonnes, plus la ré-identification est facile. La minimisation, que vous retrouverez avec le RGPD, n'est donc pas une précaution de principe : c'est une protection technique.
À retenir — Anonyme ne veut pas dire non identifiable. Ce sont les croisements qui trahissent — et celui qui ne connaît pas le contexte ne peut pas les voir.
Complétez les pointillés avec les mots : séparateur · ré-identifier · personnelle · trier · minimisation · descripteurs · supprime · CSV · croiser · manquante · identifiable · filtrer · objet
Ce qu'on réinvestit dans le projet
À la prochaine séance projet, chaque pôle triera et filtrera le fichier des réponses de l'enquête pour le faire parler : gardez l'aide-mémoire de la partie 3. Et quand il faudra choisir les données que collectera notre application, souvenez-vous de votre tableau de la question 11 : chaque colonne en plus est un risque en plus.
Sources de la partie 4 (ré-identification) :
Germain Becker, lycée Emmanuel Mounier, ANGERS
